안녕하세요 이번주 부터는 학교 공지 자동 크롤링 프로그램을 만드는 걸 목표 해보려 합니다
저도 만들어본 적은 없지만 아마
1. [학교 최신 공지 5개 제목 긁어오기] (이번주)
....
2. [수신/송신]
....
3. [자동화]
이 순으로 가지 않을까 싶습니다...
이번주는 짧습니다
[1] 필요한 라이브러리들
1. requests
파이썬에서 웹사이트로 HTTP 요청(GET이나 POST 등등..)을 보낼 때 쓰는
표준적인 라이브러리입니다.
쉽게 말해서...브라우저 주소창에 주소 치고 들어가는 행위를
코드로 대신 하기 위해서 쓰는 라이브러리라고 보면 됩니다!
2. BeautifulSoup
방금 말한 requests로 받아온 복잡하고 긴 HTML 문자열을
파이썬이 다루기 쉬운 트리 형태로 바꿔서(쉽게 말하자면 어떤 글을 문단 별로 구분된 형태로 바꾸는 것)
특정 태그나 글자를 쉽게 뽑아낼 수 있게 돕는 도구라고 보면 됩니다!
여기서 목표는 학교 공지 제목이 되겠죠...
<<<코드로 짜면 이렇게 됨
그리고 이 두 개를 갖췄으면 우리의 프로그램의 신분증(?)을 만들 차례 입니다
[2] 대상 URL 입력과 봇으로 오해하는 걸 막기 위한 헤더(신분증) 설정
(나중에 자동화까지 하면 사실 봇이 맞긴 하지만....)
<<<코드로 짜면 이렇게 됨..
1.URL
크롤링 대상인 서울과기대 학사공지 게시판 주소를 여기에 담습니다
2.header
여기에는 (브라우저인척 하기 위한...) 브라우저의 정보를 담습니다!
파이썬 기본 요청값으로 접속하면 서버 방화벽이 봇으로 인식해 403으로 차단을 때리는 경우가 대부분이기에...
"나 크롬 사용자야!"
하고 위장해 정상 접속을 보장받기 위한 필수 세팅인거죠...
[3] 페이지 요청 및 HTML 파싱
<<<코드로 짜면 이렇게 됨
1. requests.get(...)
방금 말한 URL과 헤더(신분증)을 단 프로그램이 서버에 데이터를 달라고 요청하는 겁니다...
결과적으로 단순하게 html 형식의 모든 글자가 res 에 담기게 됩니다
2. BeautifulSoup(res.text, "html.parser")
서버에서 받아온 순수 HTML 텍스트를 파이썬에 내장된 html.parser 엔진을 통해
검색 가능한 형태로 soup 안에 담는겁니다
여기서 검색 가능한 형태 라는 건 분류된 형태를 말하는 거고요
예를 들자면
대한민국을
1.경기도
1.구리시
....
2.서울
3.전라도
....
이런식으로 하나 하나 분류된 형태로 바꾸는 겁니다
이렇게 하면 주소(서울 중랑구 3,8동..)를 이용해서 찾고자 하는 걸 훨씬 쉽게 찾을 수 있게 될거고요
다시 한번 말하지만 여기서는 게시판의 제목을 찾기 위함입니다
[4] 게시판 테이블의 모든 행(Row) 선택
<<< 코드로 치면 이렇게 됨
1. soup.select("table tbody tr")
CSS 선택자를 이용해 테이블 본문(tbody) 안에 있는 모든 줄(tr)들을 리스트 형태로 가져오는 겁니다.
쉽게 말하자면 주소 검색을 해서 경기도 구리시 내에 있는 동들의 제목을 모두 가져온다고 보면 됩니다
결과적으로 게시판의 공지사항 한 줄 한 줄이 이 리스트 rows 에 하나하나씩 담기게 됩니다.
[6] 데이터 검색 및 고정 공지 필터링 (중요)
<<< 코드로 쓰면 이렇게 됨
1.for row in rows
게시판의 각 줄을 위에서부터 하나씩 검사 하는 겁니다
2.cols = row.find_all("td")
한 줄 안에서 각 칸(번호, 제목, 작성자, 작성일 등)을 나타내는 부분에는
<td>태그가 붙는데 그것들을 모두 cols에 담습니다
3. num_text = cols[0].text.strip()
cols[0]는 은행의 가장 첫 번째 칸, 즉 '게시글 번호'가 위치한 열입니다
여기에 담긴 내용을 정리해서 num_text에 담는겁니다 그리고...
4. if num_text.isdigit():
여기에서 cols[0]이 숫자로 담겨있는지 확인합니다 왜냐하면...
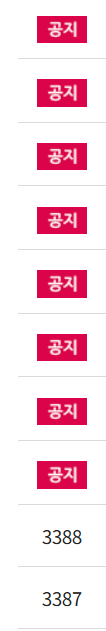
공지가 cols[0]에 담긴 경우 최신이 아닐수 있기에...
이렇게 앞에 숫자가 붙은 줄을 모두 찾으면 마지막은
5. title_tag = cols[1].find("a")
cols 리스트의 두 번째 칸 cols[1]안에서 <a>태그가 붙은 내용을 찾으면 끝납니다
보통 <a>에는 클릭 링크가 걸리고 그렇기에 보통 제목이 되기에
<a>태그가 붙은 내용을 title_tag 안에 넣으면 긴 여정은 끝나게 됩니다
title_tag 안에 내용을 print() 하던 아니면 메모장에 저장하던 할 수 있게 되기에
<<< 전체 코드, 실제로는 최신 공지 5개를 프린트 하도록 코딩함
이렇게 개략적으로 웹스크롤링의 기본의 기본을 직접 코딩해보면서 살펴보았습니다...
다음에는 본격적으로 이렇게 얻어낸 내용을 터미널에 출력시키거나
메모장으로 저장시키고 끝내는 게 아닌
수송신을 하는 방법을 알아보도록 하겠습니다..
다음편에 계속...